האם Spec-Driven Development הוא Waterfall מודרני?


10 דקות קריאה
אמ;לק
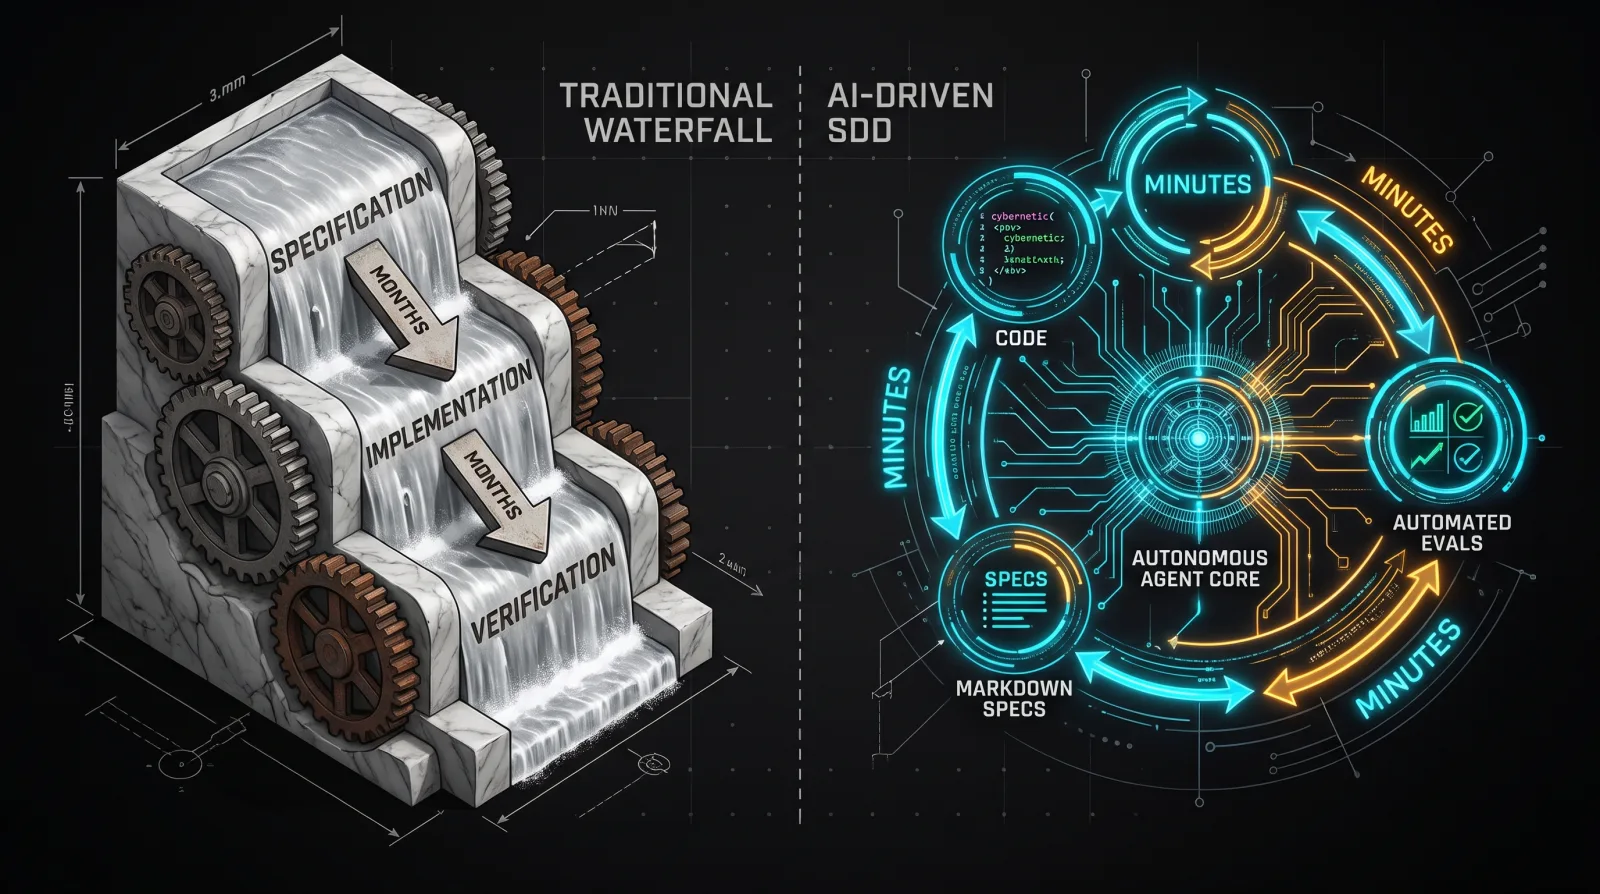
מתודולוגיית Spec-Driven Development (או SDD) נראית במבט ראשון כמו חזרה מדאיגה לימי ה-Waterfall העליזים: כותבים מסמך ארוך ומפורט, מתכננים, ורק אז מממשים. אבל Waterfall מעולם לא נכשל בגלל עצם התכנון, אלא בגלל Feedback Loop ארוך ויקר להחריד. כשסוכני AI מכווצים את עלות המימוש לשבריר שעה, מעגל המשוב מתקצר דרמטית: טעות ב-Spec כבר לא עולה רבעון, אלא חצי שעה. אם ה-Spec שלכם מתנהג כהיפותזה דינמית, חי ב-Git ונבדק ב-CI, אתם סופר-אג'ייליים. אם הוא קפוא ומנופח, אתם פשוט עושים Waterfall ב-100 קמ"ש לתוך הקיר.
רקע: תחיית ה-Spec בעולם של סוכנים
בחודשים האחרונים קשה לפתוח את הפיד בלי להיתקל במונח Spec-Driven Development (או SDD). הכלים סביב המתודולוגיה הזו מתפוצצים בכוכבים: פרויקטים כמו Spec Kit מבית GitHub (בערך 148 אלף כוכבים) ו-OpenSpec (בערך 74 אלף) זוכים לאימוץ נרחב בקהילת ה-Open Source.
ההבטחה פשוטה: במקום לזרוק פרומפטים מעורפלים ב-Chat ולסבול מהזיות (Hallucinations) ומחיקות קוד רנדומליות, אנחנו מייצרים שכבת תיווך מובנית. כותבים Spec מפורט, גוזרים ממנו תוכנית עבודה (Plan) ורשימת משימות אטומיות (Tasks), ורק אז משחררים את הסוכן לכתוב קוד.
אבל מתחת להתלהבות, מתעורר דיבייט ארכיטקטוני חריף בקרב מהנדסים ותיקים. פרנסואה זנינוטו (François Zaninotto), מייסד Marmelab, ניסח את זה בחדות בפוסט המדובר שלו: Spec-Driven Development: The Waterfall Strikes Back. הטענה שלו פשוטה: פיצ'ר טריוויאלי ב-Spec Kit ייצר 8 קבצים מנופחים ו-1,300 שורות Markdown לפני שנכתבה שורת קוד אחת. קהילת ההנדסה ב-Hacker News הדהדה את התחושה: האם שרפנו עשרים שנה של תנועת ה-Agile, CI/CD ואיטרציות מהירות רק כדי לחזור למסמכי אפיון אינסופיים?
ההגדרה החדה ביותר לפער הזה נוסחה על ידי המשתמש pydry ב-Hacker News: ההבדל האמיתי בין Waterfall ל-Agile הוא כמות ה-Spec שאתה כותב לפני שאתה מתחיל לממש.
איך זה עובד: מכניקת ה-Spec Engine
כדי להבין האם אנחנו באמת ב-Waterfall, בואו נצלול לקרביים של מנועי SDD מודרניים. המטרה של המערכות האלה היא לתחם את מרחב החיפוש הלא-דטרמיניסטי של מודלי שפה (LLMs) לתוך State Machine ברור ומבוקר קונטקסט.
┌────────────────────────────────────────────────────────┐
│                   SDD State Machine                    │
└────────────────────────────────────────────────────────┘
                           │
                           ▼
                  ┌─────────────────┐
                  │  Constitution   │ (Global Constraints & Architectural Rules)
                  └────────┬────────┘
                           │
                           ▼
                  ┌─────────────────┐
                  │  Specification  │ (Feature Boundaries & User Stories)
                  └────────┬────────┘
                           │
                           ▼
                  ┌─────────────────┐
                  │ Architectural   │ (Component Design, Data Schemas, Contracts)
                  │      Plan       │
                  └────────┬────────┘
                           │
                           ▼
                  ┌─────────────────┐
                  │ Task Breakdown  │ (Atomic, Ordered Checklists)
                  └────────┬────────┘
                           │
                           ▼
                  ┌─────────────────┐
                  │ Implementation  │ (Agent Execution Loop)
                  └────────┬────────┘
                           │
                           ▼
              ┌─────────────────────────┐
       No ─── │ Converged & Validated?  │ ◄──── (Evals, Unit Tests, Type Check)
       ▲      └────────────┬────────────┘
       │                   │ Yes
       │                   ▼
  (Refine Spec)       ┌─────────┐
       └──────────────┤ Archive │
                      └─────────┘
בכלים מבוססי State Machine קלאסיים (כמו Spec Kit), הזרימה עוברת דרך שלבים מוגדרים היטב:
- Constitution: הגדרת חוקי ברזל מערכתיים (למשל: ספריות מותרות, קונבנציות לוגים, מגבלות ביצועים).
- Specify: ניסוח ה-Behavior והדרישות של הפיצ'ר ללא תלות בקוד.
- Plan: הפשטה ארכיטקטונית: אילו קבצים, Schemas ו-APIs יושפעו.
- Tasks: פירוק המשימה למקטעים אטומיים (Atomic Tasks) כדי למנוע Context Window Overflow וקריסה קוגניטיבית של הסוכן.
- Implement & Converge: סבב מימוש שבו הסוכן מבצע, מריץ בדיקות, וחוזר ל-Spec עד שכל התנאים מתקיימים באופן מלא.
ב-OpenSpec הזרימה רזה יותר ומבוססת על מבנה Git טבעי: תיקיית השינוי מחזיקה את שלב ה-propose, לאחר מכן הרצה (apply), ולבסוף גניזה (archive). ה-Spec הוא קובץ טקסט שחי בתוך ה-Repository לצד הקוד, מנוהל בגרסאות ומשמש כ-Single Source of Truth לסוכן ולמהנדס.
קוד לדוגמה: מעגל בדיקות מונחה Spec (Spec-as-Code)
הטעות הגדולה ב-SDD היא כתיבת מסמך דרישות "פסיבי" שלא ניתן לאימות אוטומטי. בעולם הנדסי מתקדם, ה-Spec חייב לתפקד כ-Executable Contract.
הנה דוגמה להמחשה (כתבתי אותה לצורך הפוסט, היא לא לקוחה מפרויקט אמיתי) למבנה Spec מודרני מבוסס Markdown ו-Metadata, הכולל חוזה API נוקשה ומערך אימות (Evals):
# Specification: Distributed Rate Limiting Middleware

## Architectural Context
- **Target Component:** API Gateway proxy layer
- **Engine:** Redis 7 Cluster using sliding-window script
- **Throughput Budget:** Max 1.2ms latency overhead per request at P99

## Behavioral Contract
1. Every incoming request with header `X-API-Key` must consume tokens according to tier.
2. If token count exceeds window limit, reject immediately with HTTP 429 Too Many Requests.
3. Response headers must inject:
   - `X-RateLimit-Limit`
   - `X-RateLimit-Remaining`
   - `X-RateLimit-Reset`

## Invariant Tests & Evals
- [ ] Concurrent burst test: 1,000 req/sec from identical key must throttle precisely at threshold.
- [ ] Redis connection failure mode: Fail-open with alert telemetry (do not crash Gateway pipeline).
וכך נראה קוד הבדיקה (Test Contract) שמאמת את ה-Spec באופן אובייקטיבי ב-CI, בלי להסתמך על שיקול הדעת של הסוכן:
import { describe, it, expect, beforeAll } from 'vitest';
import { ApiGatewayClient } from '../clients/gateway';
import { RedisClusterMock } from '../mocks/redis';

describe('Spec Verification: Distributed Rate Limiting Middleware', () => {
  let gateway: ApiGatewayClient;
  let redisMock: RedisClusterMock;

  beforeAll(async () => {
    gateway = new ApiGatewayClient({ baseUrl: 'http://localhost:8080' });
    redisMock = new RedisClusterMock();
  });

  it('enforces exact sliding window threshold under concurrent burst', async () => {
    const apiKey = 'test-org-tier-pro';
    const totalRequests = 120;
    const allowedLimit = 100;

    const responses = await Promise.all(
      Array.from({ length: totalRequests }).map(() =>
        gateway.get('/v1/telemetry', { headers: { 'X-API-Key': apiKey } })
      )
    );

    const accepted = responses.filter(r => r.status === 200);
    const throttled = responses.filter(r => r.status === 429);

    expect(accepted.length).toBe(allowedLimit);
    expect(throttled.length).toBe(totalRequests - allowedLimit);
    expect(throttled[0].headers['x-ratelimit-remaining']).toBe('0');
  });

  it('fails open when Redis cluster degrades or drops connection', async () => {
    await redisMock.simulatePartition();

    const response = await gateway.get('/v1/telemetry', {
      headers: { 'X-API-Key': 'fail-open-test' }
    });

    expect(response.status).toBe(200);
    expect(response.headers['x-ratelimit-degraded']).toBe('true');
  });
});
ניתוח מעמיק: למה המתמטיקה של Waterfall השתנתה?
בואו נצלול לעומק התיאוריה של הנדסת תוכנה. למה Waterfall נכשל היסטורית?
הוא לא נכשל בגלל עצם הרעיון של תכנון מוקדם. הוא נכשל בגלל עקומת עלות השינוי (Cost of Change Curve): ככל שטעות נחשפת מאוחר יותר במחזור הפיתוח, תיקונה יקר יותר. המחקר של בארי בוהם (Barry Boehm) הוא המקור הקלאסי לרעיון הזה. עד כמה העקומה תלולה היום זו שאלה שנויה במחלוקת, אבל הכיוון מוסכם: טעות בדרישות זולה, וטעות שנחשפת ב-Production יקרה.
כדי להתגונן מפני העלות המפלצתית של שגיאה שנמצאת מאוחר, Waterfall ניסה להנדס "שלמות" מראש באמצעות מסמכי אפיון אינסופיים (Upfront Design). אג'ייל קם ואמר: במקום לנסות לחזות את העתיד, נקצר את האיטרציות למחזורים של שבועיים, כדי שהמשוב יגיע מהר לפני שהבור יעמיק.
קריסת עלות המימוש
ה-AI לא שינה את החשיבה האנושית, הוא שינה את עלות המימוש (Cost of Implementation).
כפי שאדי אוסמני (Addy Osmani) מסביר, ה-AI מכווץ את מחזור חיי הפיתוח באופן לא סימטרי:
- שלב הדרישות, הארכיטקטורה וקבלת ההחלטות נשאר איטי, כי הוא תלוי בשיקול דעת אנושי.
- שלב המימוש (כתיבת הקוד, החיווט, ה-Boilerplate) התרסק מחודשים ושבועות לדקות ספורות.
התוצאה הארכיטקטונית מהפכנית: טעות ב-Spec כבר לא עולה רבעון של עבודת צוות. היא עולה שעה של ריצת סוכן.
רוג'ר וונג (Roger Wong) טבע את המונח הציני אך המדויק: אג'ייל במעיל טרנץ'. אתה כותב Spec קצר ומדויק, מייצר קוד, מגלה תוך 20 דקות שההנחות שלך היו שגויות, מתקן את ה-Spec ומייצר מחדש. זה נראה חיצונית כמו Waterfall (כותבים מסמך ואז מייצרים קוד), אבל מתנהג מהותית כמו Agile טהור, כי ה-Feedback Loop קצר בצורה קיצונית. כפי שדייוויד היינמאייר הנסון (DHH) ציין בשיחתו עם לקס פרידמן: העבודה עם סוכנים דורשת אג'יליות רדיקלית אפילו יותר. מגדירים תוצאה רצויה, נותנים לסוכן לרוץ, משתמשים במה שנבנה, ומבצעים איטרציה מיידית.
מתי SDD נשאר אג'ילי, ומתי הוא נשבר ל-Waterfall קלאסי
אי אפשר לעשות קיצורי דרך אינטלקטואליים: מהירות לבדה לא מבטיחה אג'יליות. כדי ש-SDD לא יתנוון ל-Waterfall, הוא חייב לציית לשלושה עקרונות ברזל:
- ה-Spec הוא היפותזה, לא חוזה משפטי: מרטין פאולר (Martin Fowler) ואונמש ג'ושי (Unmesh Joshi) חידדו נקודה קריטית: אי אפשר לתכנן מערכת מושלמת מראש. בדיון ב-r/ExperiencedDevs חזר אותו רעיון: Spec לא נכתב מראש, הוא מתגלה תוך כדי עבודה. העיצוב האמיתי מתגלה תוך כדי תנועה. מי שמנסה לנעול Spec "חסין כשלים" כדי לברוח מאי-ודאות, כפי שיובל ירת מזהיר, חוזר היישר ל-Waterfall.
- ה-Spec נמשך למעלה (Pull), לא קדימה (Push): כפי שמארק ברוקר (Marc Brooker) מ-AWS מדגיש, ה-Spec לא נועד לתכנן חצי שנה קדימה. הוא מתרכז ברמת ההפשטה (Abstraction Layer) הנוכחית. ה-Spec הוא המסמך שעליו עושים איטרציות, והקוד הוא תוצר לוואי שלו. (שימו לב: ברוקר עובד על Kiro, כלי SDD של AWS, כך שיש לו אינטרס.)
- Spec-as-Code עם Invariants ברי בדיקה: Spec שלא נבדק ב-CI הוא בסך הכל משאלת לב. הוא חייב להכיל Golden Datasets, בדיקות חוזים (Contract Tests) ו-Evals נוקשים.
| פרמטר ארכיטקטוני | SDD אמיתי (Agile Loop) | Waterfall בתחפושת (Spec Trap) |
| מחזור משוב (Feedback Loop) | דקות עד שעות בודדות | ימים עד שבועות |
| יחס לשינוי ב-Spec | נזיל ומתעדכן על בסיס קוד רץ | קפוא; שינוי דורש "אישור ועדת שינויים" |
| תפקיד ה-Review האנושי | אימות ארכיטקטורה, חוזים ובדיקות | קריאה ידנית מייגעת של אלפי שורות קוד |
| בדיקות אימות | אוטומטיות דרך CI / Evaluators | סובייקטיביות ("הסוכן אמר שהכול עובד") |
| גודל ה-Scope | משימות תחומות (Vertical Slices) | מערכות שלמות שנכתבות מקצה לקצה |
איפה המנגנון מתפרק בפועל?
בואו נניח את האמת ההנדסית על השולחן: יש כמה כשלים מבניים שרוב המקדמים של הכלים האלה שוכחים לציין.
צוואר הבקבוק עבר ל-Review האנושי. רייצ'ל לייקוק (Rachel Laycock) מ-Thoughtworks צודקת לחלוטין כשהיא טוענת שה-AI לא שבר את ה-Code Review. אנחנו פשוט העמסנו עליו מעבר ליכולת הקיבול שלו. כשיש לך 8 עד 12 סוכנים שמייצרים שינויים במקביל, המוח האנושי הופך לצוואר הבקבוק היחיד. לפי הערכה של Laimonade (חברה שמוכרת כלים בתחום, ולכן יש לה אינטרס), נדרשות כ-40 דקות להגדיר משימה מדויקת לסוכן, ועוד 10 עד 20 דקות לבדוק אותה. לפי אותה הערכה, בערך חצי מהעבודה החוזרת נובעת מפגם ב-Spec ולא במימוש.
תופעת ה-Spec Drift והתיאטרון ההנדסי. ללא משמעת מחמירה, קל מאוד להגיע למצב של Spec Drift: הקוד מתקדם באמצעות פאטצ'ים מהירים, וה-Spec הופך למסמך מיושן ולא רלוונטי. במקרים הגרועים ביותר, כפי שתואר ב-r/ExperiencedDevs, מפתחים כותבים פרומפט מרושל של שתי שורות, מייצרים Spec ענק באמצעות LLM, מייצרים קוד ופותחים Pull Request בלי לקרוא מילה. זה אינו SDD, זה תיאטרון הנדסי מסוכן.
היעדר Data מבוסס תעשייה. כמעט כל הנתונים, סיפורי ההצלחה והגרפים שמסתובבים ברשת מגיעים מפרויקטי Green-field של מפתחים בודדים או מחברות שמנסות למכור מתודולוגיות וכלים משלהן. עדיין חסר מחקר הנדסי אמפירי רחב היקף שמודד את התחזוקתיות של קוד מונחה-סוכנים במערכות Enterprise מורכבות ומרובות Legacy לאורך זמן.
3 שאלות אבחון עצמי: האם אתם אג'ייליים או פשוט מהירים?
אם אתם מיישמים SDD בצוות, שאלו את עצמכם את שלוש השאלות הבאות:
- האם ה-Spec שלכם השתנה אחרי שראיתם קוד רץ ב-Staging? אם התשובה היא לא, אתם לא עובדים באיטרציות; אתם מבצעים Waterfall קלאסי עם מנוע הקלדה מהיר במיוחד.
- האם מחזור האיטרציה המלא נמדד בשעות בודדות? אם כתיבת ודיוק ה-Spec לפיצ'ר בודד אורכת שבוע של דיונים ללא מגע עם המערכת, איבדתם את כל יתרון המהירות של סוכני הפיתוח.
- האם יש Test או Eval אובייקטיבי שמוודא שה-Spec התקיים? Spec ללא ולידציה אוטומטית שאינה תלויה בסוכן שכתב את הקוד הוא בסך הכל משאלת לב.
סיכום
האם Spec-Driven Development הוא Waterfall? בצורה החיצונית, בהחלט כן. בדינמיקה הפנימית ובתוצאה, לא בהכרח.
Waterfall מעולם לא היה שיטה בעייתית בגלל הרצון לחשוב ולתכנן לפני שכותבים. הוא היה שבור כי מחיר הטעות היה קטלני, וכל משוב דרש חודשים של עבודה ידנית. הופעת סוכני ה-AI שברה את המשוואה הזו: היא כיווצה את עלות המימוש לכמעט אפס, ומאפשרת לנו לתכנן, לבנות, לטעות, ללמוד ולתקן, הכול באותו יום עבודה.
אג'ייל מעולם לא אמר "אל תתכננו". אג'ייל אמר: תלמדו מהר. וכשיש בידיים שלכם כלי שמסוגל להפוך Spec למערכת עובדת בתוך עשרים דקות, ה-Spec מפסיק להיות בית כלא בירוקרטי והופך להיות המצפן ההנדסי החדש שלכם.